仿真实训为什么不能只是记录学员是否完成任务?
“任务完成”只能说明结果,不能解释学员怎样完成、在哪个环节犹豫、是否采用了高风险姿势,也不能区分熟练操作与偶然成功。仿真实训要形成可复盘、可评价、可持续改进的闭环,需要把全身动作、路线、工具状态、任务事件和环境交互放在同一时间轴上。无标记动作捕捉减少人体穿戴和准备负担,适合反复训练与多人场景;但动作数据只是证据,评分规则仍必须由行业专家依据训练目标建立并验证。
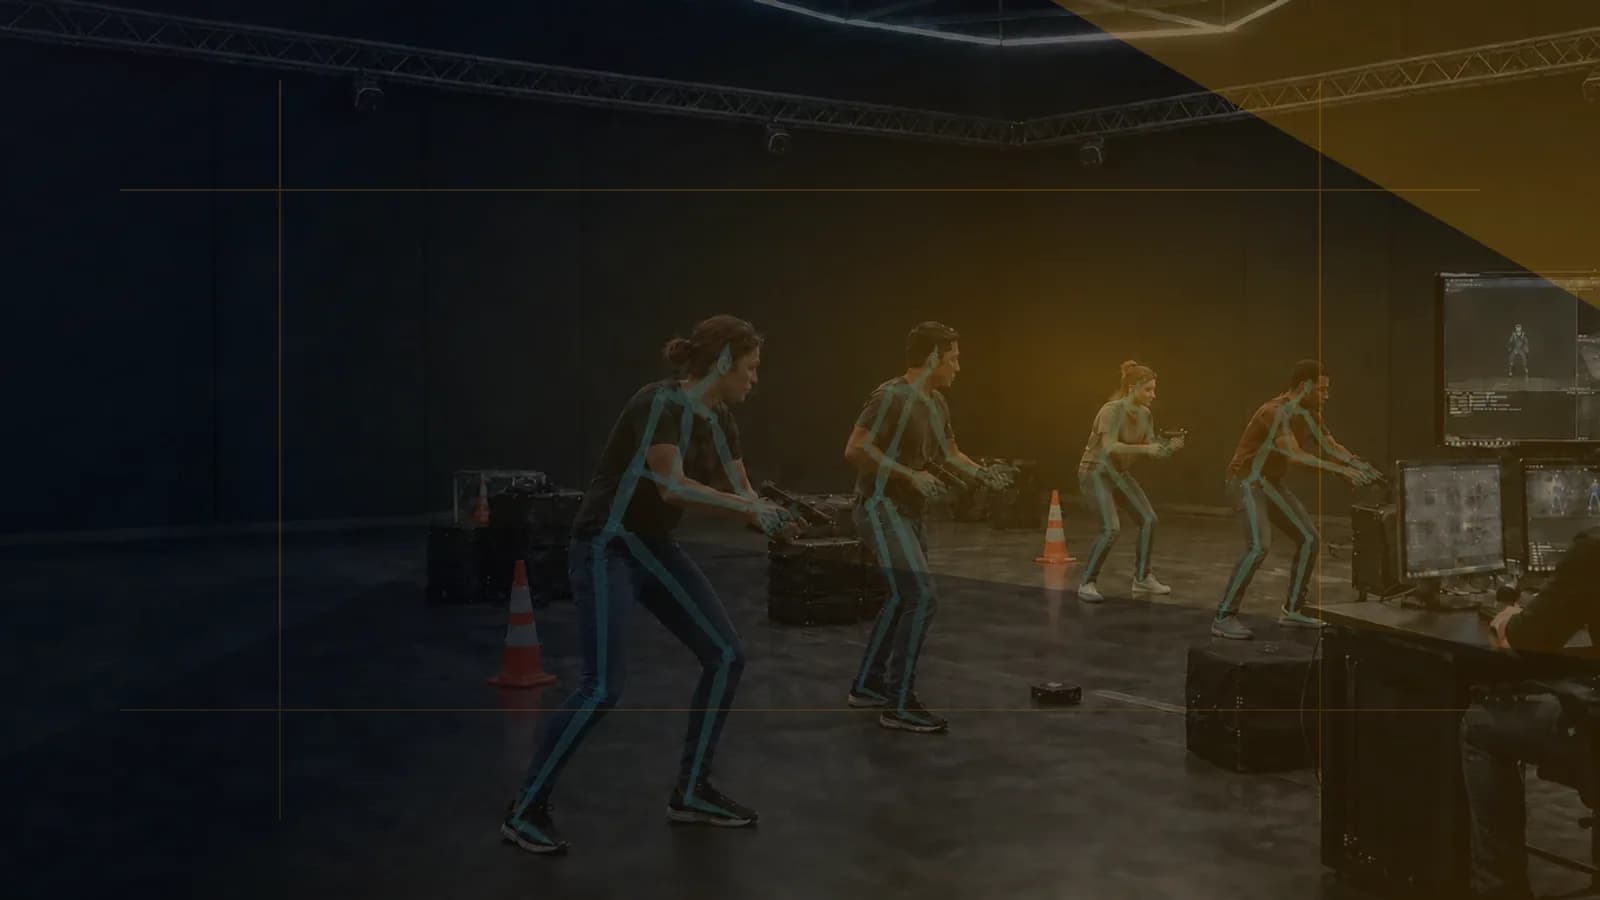
核心观点: “任务完成”只能说明结果,不能解释学员怎样完成、在哪个环节犹豫、是否采用了高风险姿势,也不能区分熟练操作与偶然成功。仿真实训要形成可复盘、可评价、可持续改进的闭环,需要把全身动作、路线、工具状态、任务事件和环境交互放在同一时间轴上。无标记动作捕捉减少人体穿戴和准备负担,适合反复训练与多人场景;但动作数据只是证据,评分规则仍必须由行业专家依据训练目标建立并验证。
在培训现场,我们最容易记录的是两个结果:学员有没有完成任务,用了多长时间。
这两个指标重要,却远远不够。
一名学员可能在规定时间内完成设备检修,但中途跨过危险区域、反复弯腰、遗漏检查步骤;另一名学员可能速度略慢,却始终保持安全距离、正确使用工具并及时与队友确认。只看“完成/未完成”和总用时,二者差异会被压缩成一个简单分数。
仿真实训的真正价值,是在没有现实后果的条件下暴露过程问题,并通过复盘把经验转化为稳定能力。
一、结果指标无法解释能力结构
技能不是单一速度。它通常同时包括任务理解、步骤顺序、空间判断、身体控制、工具使用、风险意识、团队协作和异常处理。
总用时只能描述任务持续多久。用时缩短可能来自熟练,也可能来自跳过检查;任务完成可能说明动作有效,也可能只是偶然成功。对设备检修、消防演练、应急处置、特种作业或医疗模拟而言,错误步骤即使没有立刻导致失败,也可能对应真实场景中的严重风险。
所以,我们需要把一次训练拆成可观察的过程:何时进入区域,先看了哪里,身体如何接近设备,哪只手拿取工具,工具以什么方向操作,是否出现停顿或返工,何时与队友交接,最后怎样退出。
二、过程评价至少包含五类数据
第一类是时间与事件。任务开始、阶段转换、接触、报警、错误和完成发生在哪个时间点。它能帮助我们把总用时拆成有意义的步骤用时。
第二类是空间路线。学员在场地中的行走路径、停留区域、接近方向与安全边界。路线可以揭示绕行、拥堵、盲区和不必要移动。
第三类是人体动作。躯干、髋、膝、肩、肘和手如何配合,是否出现过度前屈、失衡、伸手越界或错误发力。
第四类是工具和对象状态。工具被谁拿起、以什么姿态接近目标、是否放回正确区域,阀门、把手、设备模块是否到达指定状态。
第五类是团队关系。多人是否在狭小区域相互阻挡,交接是否清晰,危险动作发生时同伴是否及时响应。
只有这些数据位于同一时间轴上,我们才能把某个时间点发生了错误还原为完整情境。
三、为什么只追踪头显和手柄仍然不够
很多VR系统明确知道头显和控制器的6DoF位置。对视线方向、手部交互和基本移动而言,这些数据很有价值。但用头和手推断全身,仍可能遗漏关键姿态。
两名学员的头、手位置相似,躯干和下肢策略可能完全不同:一人通过屈膝下蹲靠近设备,另一人则弯腰并扭转躯干;一人双脚稳定站立,另一人可能跨越安全线。对于搬运、俯身检查、跪姿操作、攀爬和多人协作,身体中段与下肢不能只靠推测。
增加腰、膝、踝等可穿戴追踪器能提高信息量,却会带来绑定、编号、配对、充电、清洁、校准和维护。训练规模越大、学员流转越快,运营负担越明显。
无标记多相机动捕提供了另一种选择:把感知能力部署在场地,让学员以较少人体穿戴进入训练。头显、控制器和关键工具仍可使用专门刚体追踪,全身动作则由视觉系统获得。
四、实时反馈与训练后复盘不是同一件事
仿真实训常希望即时提示,例如学员进入危险区、身体靠近运动设备或动作超出安全范围。实时数据能够驱动虚拟角色、交互逻辑和现场监控。
但不是所有错误都应该即时打断。过多提示会改变学员决策,让系统变成逐步导航,而不是能力测试。一些问题更适合训练结束后复盘:为什么此处停顿,为什么改换路线,为什么工具反复调整。
因此,我们会把数据用途分开:
- 实时层负责角色驱动、区域触发、明显安全边界与采集质量;
- 复盘层负责动作片段、阶段用时、路线、工具状态和多次训练比较;
- 评价层依据行业规则把证据转换为评分、反馈或教练建议。
五、动作数据怎样支持一次有效复盘
好的复盘不是把整段录像重新播放一遍,而是帮助学员把主观感受与客观过程对齐。
例如,学员说“我只停了一下”,系统可以定位停顿持续时间以及当时工具、身体和设备的关系;教员指出“接近方向不安全”,路线与身体朝向可以显示问题从何时开始;多人训练中,时间轴可以还原谁先进入区域、谁遮挡了谁、交接信息是否滞后。
动作数据还可以支持同一学员的纵向比较。第一次训练可能步骤正确但动作生硬,第二次路线更短,第三次在压力条件下仍保持稳定。相比一次总分,变化曲线更能帮助教员判断技能是否真正形成。
不过,指标越多并不等于反馈越好。每个课程应围绕少数关键目标设计:安全边界、核心步骤、工具姿态、身体策略或团队节奏。无关指标会增加解释负担,甚至诱导学员追求分数而不是任务能力。
六、思看(Semcam Live)怎样进入仿真实训场地
思看(Semcam Live)无标记动捕系统采用固定同步多相机与边缘AI相机阵列。人体不需要动捕服、惯性节点或反光标记点,相机端完成目标检测、跟踪、二维关键点、分割、ReID和置信度计算,Active Center在本地完成跨相机匹配、三维重建、骨骼、IK、滤波、重定向与输出。
实时链路120fps,端到端时延低于100ms,可用于全身角色驱动、区域交互、现场预览和采集质控。需要训练后分析时,PRO+与ULTRA版还可使用HPE进行采后非实时处理,为关键动作片段提供更高质量的关键点结果。
对于头显、控制器、工具、训练器械、把手和场景对象,Goku可以提供刚体6DoF光学追踪,并与人体数据在Active Center中共享项目、坐标系和时间轴。这样,学员身体、工具和场景事件不再分散在相互独立的日志里。
系统面向Unreal Engine、Unity、C++、Python、FBX和BVH等流程提供接口方向,适合对接虚拟角色、训练逻辑和分析平台。
七、真正的数字化实训,是把过程变成可学习的证据
仿真环境能够安全复现高成本、高风险或低频任务,但“进入仿真”并不自动意味着训练可量化。只记录任务完成与总用时,我们仍然不知道能力如何形成,也不知道错误发生在哪里。
无标记动作捕捉让全身过程数据更容易进入日常训练;刚体追踪补足工具和对象状态;统一时间与坐标则把人、物、环境和事件连接起来。教员因此可以更快定位关键片段,学员也能看到自己的主观感受与真实动作之间的差异。
动作数据不能替代课程设计和专家评价,却能让评价不再只依赖记忆与印象。对于希望提升训练质量的机构,这项能力比增加一个炫目的虚拟场景更基础:它让每一次训练都留下可解释、可比较、能够指导下一次练习的证据。